同样一个主题,写了两版内容,AI 引用量差距高达 10 倍。本文对比两版在选题、结构、语言上的差异,找出决定引用量的关键变量。
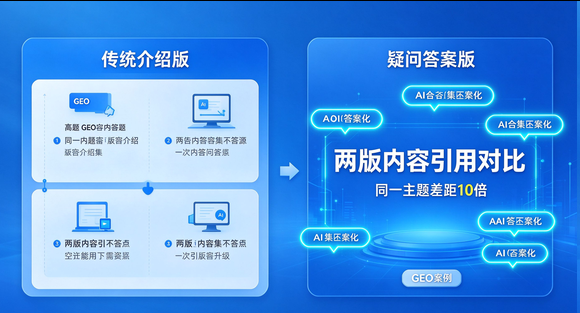
做 GEO 的时候,我做过一次很直观的对比实验:同一个主题,我写了两版内容,分别发布在两个结构一样的栏目里,跟踪了两个月,最后 AI 引用量差了将近 10 倍。两版都是自己写的,内容质量都不算差,那差距到底出在哪?拆开来看,差距集中在几个关键变量上,做 GEO 的朋友可以参考着自检。
变量一:标题的 "提问贴合度"。 第一版标题是 "XX 证书全面介绍",偏传统 SEO 写法,大而全;第二版标题是 "XX 证书怎么报考,需要准备哪些材料",是完整的疑问式长尾词。结果是:疑问式标题被模型精准匹配到真实提问的概率高得多。模型是按 "问题和答案" 的对应关系取内容的,你的标题不像是回答某个问题,模型就难把它分配到合适的问题下去引用。这一个变量,就拉开了很大差距。
变量二:开头有没有 "可摘走的一句话"。 第一版开头是背景铺垫,先讲这个证书的由来、发展,讲了半天还没到重点;第二版开头第一句就是结论 ——"XX 证书报考需要身份证、学历证明、证件照,按这三步准备即可"。模型引用内容时,倾向于直接摘取能独立成立、直接回答问题的话。能一句话拿走的,模型取用成本低,自然更愿意用。开头不直接给答案的,模型提取起来费劲,就会被其他更 "干脆" 的内容替代。
变量三:结构的 "分段可引用性"。 第一版是大段大段的连续文字,一个主题揉在一起讲;第二版每个小节独立回答一个小问题,小节之间还能单独成立。模型取用内容时,是 "按段取" 的,小节越独立、越能单独回答一个问题,被取用的概率越高。连续长文看似内容多,但模型很难从中精准切出一段来用。
变量四:语言的 "口语化程度"。 第一版书面腔重,长句多、术语多;第二版改成短句、口语化、像在跟人讲。模型引用的内容最终是展示给普通用户的,口语化内容更贴合用户阅读习惯,被模型 "选中展示" 的概率也更高。
同一主题,两版内容引用量差 10 倍,核心差别就四个:标题贴不贴合提问、开头给不给结论、结构能不能分段引用、语言口不口语化。这四个变量,是 GEO 内容能否被引用的 "分水岭",值得逐条自检。